ORM vs Raw SQL 🪑
Un éternel débat où certains plaident pour la « commodité » et d'autres pour le « contrôle ».
🪑 Chaise n°1 : SQLAlchemy ORM
L'ORM n'est pas une question de vitesse de code, mais de rapidité de livraison des fonctionnalités. Vous travaillez avec des objets, pas avec des chaînes de caractères.
✅ Pourquoi c'est génial :
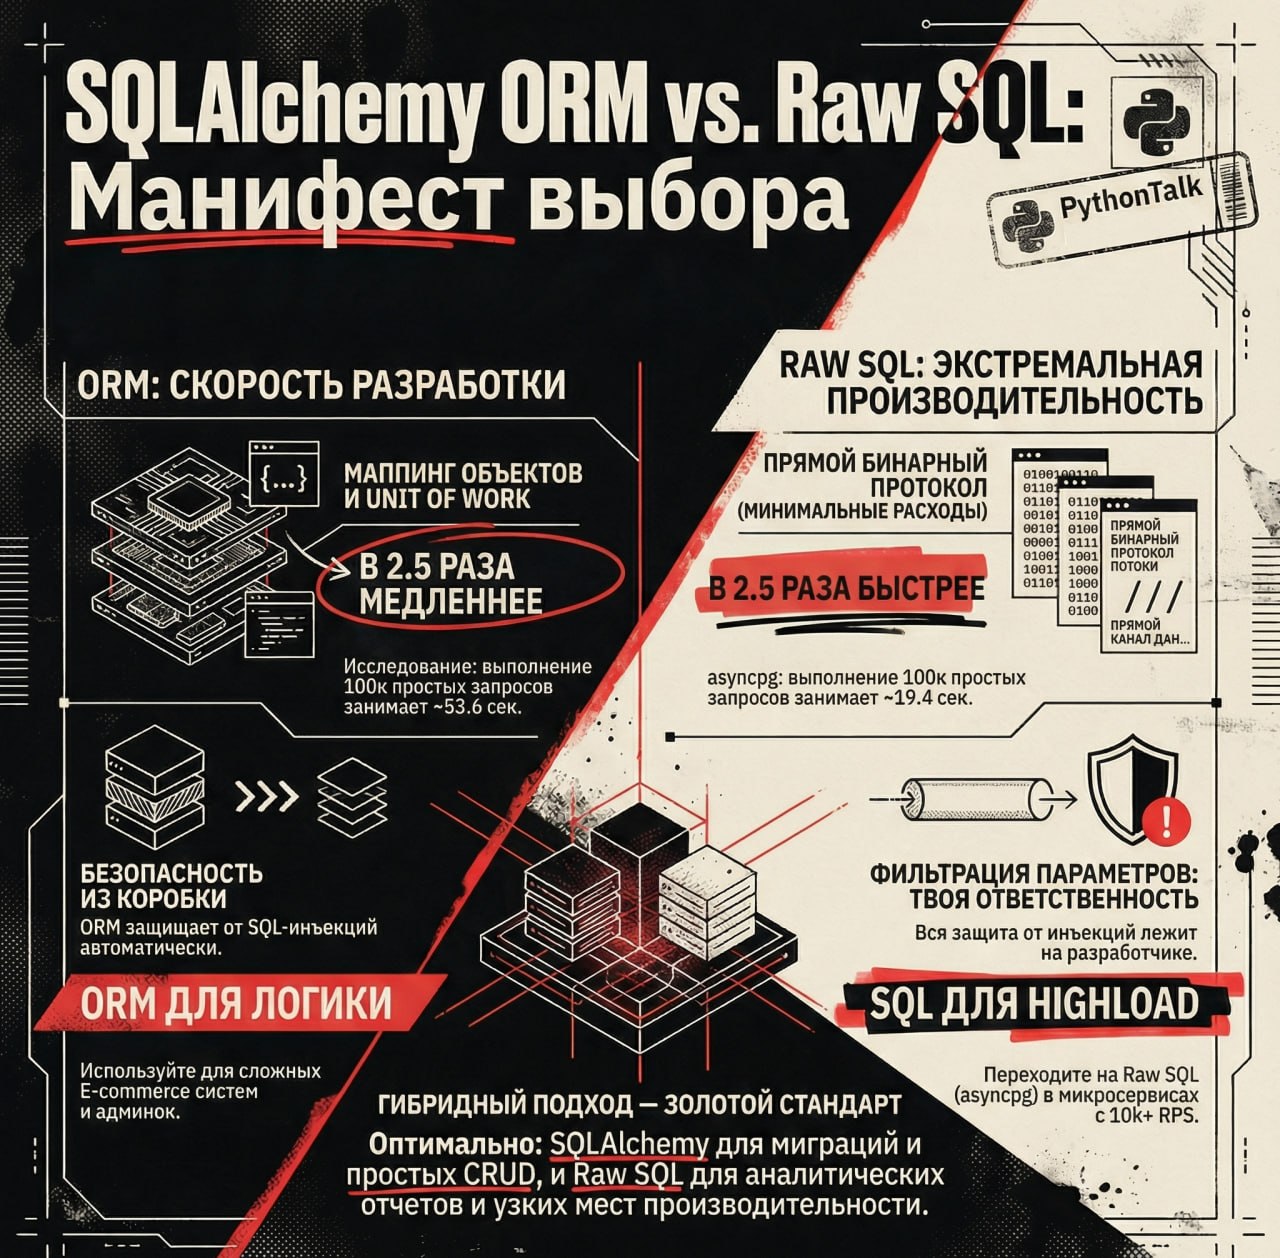
— Unit of Work : Alchemy surveille elle-même les modifications des objets et les pousse dans la base en un seul paquet transactionnel.
— Sécurité : Les injections SQL ? Oubliez. Si vous n'utilisez pas
.text(), vous êtes protégé par défaut.— Migrations : Synchroniser le schéma de la base avec vos modèles, c'est de la magie qui vous fait gagner des heures de routine.
— Logique métier : Idéal pour les systèmes e-commerce complexes et les panneaux d'administration où les relations entre les tables sont plus embrouillées que l'intrigue d'« Interstellar ».
❌ Quel est le piège :
— Overhead : Le mapping d'objets est une opération coûteuse. Sur de grands ensembles (100k+ lignes), vous sentirez le processus Python consommer mémoire et CPU.
— Problème N+1 : Le principal tueur de performances. Un seul
.joinedload() oublié et votre service s'effondre sous une avalanche de petites requêtes.🪑 Chaise n°2 : Raw SQL / asyncpg (Le choix pour le Highload)
Quand vous êtes limité par les performances, les couches d'abstraction commencent à gêner.
✅ Pourquoi c'est génial :
— Vitesse extrême : Une différence de 2,5 fois, ce n'est pas une blague. Le protocole binaire d'
asyncpg permet d'exploiter au maximum le canal réseau.— Contrôle total : Vous écrivez exactement le SQL qui ira dans le planificateur de la base. Pas de magie superflue de l'ORM.
— Fonctionnalités spécifiques de la base : Essayez d'utiliser efficacement
JSONB ou des index spécifiques de Postgres via l'ORM – cela devient parfois un travail de Sisyphe.❌ Quel est le piège :
— Votre responsabilité : Vous avez oublié d'échapper les paramètres ? Félicitations, la base est compromise.
— Code répétitif : Vous devrez mapper manuellement les tuples de la base vers des modèles DTO/Pydantic. C'est ennuyeux et génère des erreurs.
— Maintenance : Relire 500 lignes de SQL brut dans le code six mois plus tard, c'est un plaisir douteux.
💡 Verdict : L'approche hybride est la norme en or
Il ne faut pas choisir une seule approche. L'architecture moderne ressemble à ceci :
1. SQLAlchemy ORM – pour 90% des tâches : CRUD, logique métier, migrations et panneau d'administration.
2. SQLAlchemy Core – quand les objets ORM sont trop lourds, mais que vous n'avez pas encore envie d'écrire des chaînes brutes.
3. Raw SQL (asyncpg) – pour les goulots d'étranglement : rapports analytiques, insertions massives et microservices avec une charge de 10k+ RPS.
Choisissez la chaise en fonction de la charge ☝️
Et vous, avec quoi écrivez-vous ?
👨💻 ORM uniquement, la vie est trop courte pour écrire du SQL à la main.
👨💻 Raw SQL uniquement, je ne fais pas confiance à cette magie.
#deux_chaises
Commentaires
0Aucun commentaire pour le moment.
Connectez-vous pour participer à la discussion.